AI新聞
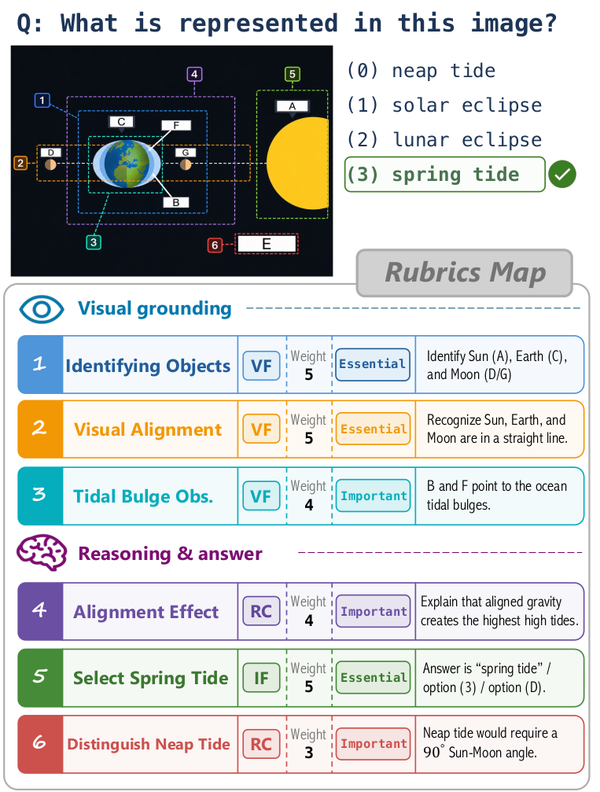
V-Rubrics 是什麼?AI 看圖答對也可能看錯,用細項評分檢查視覺推理
V-Rubrics 把視覺依據、推理一致與指令遵循拆成細項回饋,改善多模態 AI 訓練。本文用圖表與票據示例解釋答案分數的盲點,整理官方資料集與實驗,說明評分表如何對準真正證據。
AI新聞
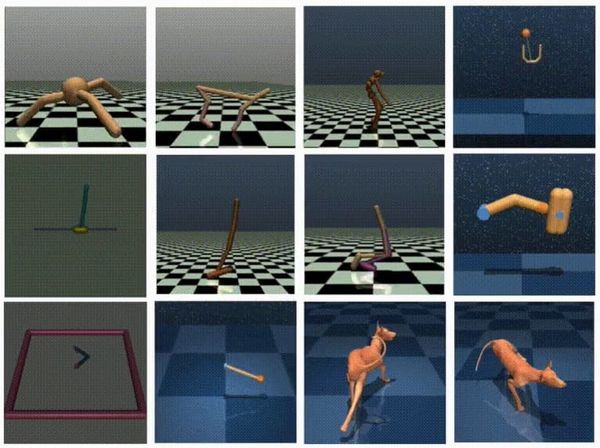
Gautham Vasan 的博士研究探討機器人即時強化學習,AVG 每次互動更新一次,不儲存經驗重播資料。本文解析串流學習、遠端與本機分工,以及真實機器人數小時學習的實驗界線。
AI新聞
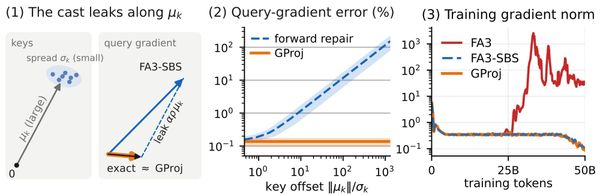
GProj 研究發現,低精度注意力運算可能在沒有明顯報錯時累積梯度偏差。本文用白話解析 BF16、FlashAttention 與數值穩定,整理官方實驗與修正,說明速度和正確性為何需要一起驗證。
AI新聞
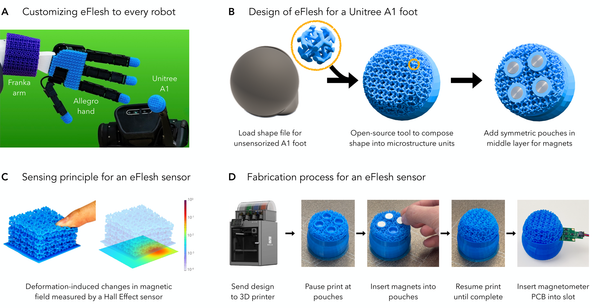
eFlesh 用可列印結構、磁鐵與磁性感測建立可自訂觸覺皮膚。本文解析磁場如何讀出接觸、官方測試與成本,說明不到五美元指的是磁鐵,以及開源設計如何配合不同機器人。
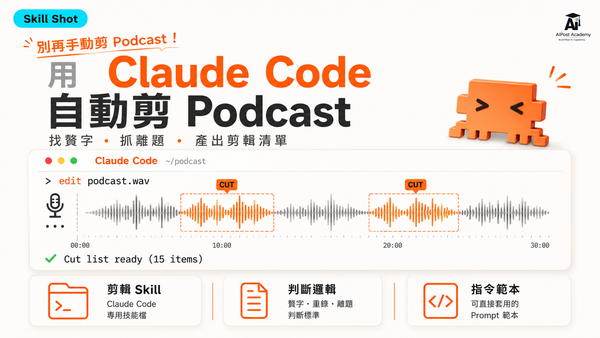
先理解 Claude Code 如何整理逐字稿、標記重錄與離題內容,以及為什麼正式剪輯仍需要人工確認與完整試聽。
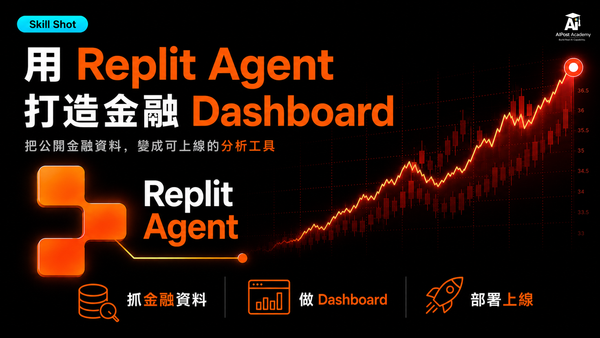
先看懂 Replit Agent 如何把公開資料變成金融 Dashboard,以及資料格式、網站改版與更新失敗為什麼比介面更重要。
AI 郵報啟動 2026 年度讀者調查,從效率、收入到職場中的 AI 能力落差,了解最常接觸 AI 的這群人,究竟把工具變成了成果,還是換來更多工作。 生成式 AI 已經進入許多人的日常。有人用它寫信、整理資料,有人把它放進工作流程,甚至靠 AI 接案、開發產品或創造新的收入。 但當 AI 工具越來越普及,一個更實際的問題也逐漸浮現:我們真的因為 AI 變得更有效率了,還是只是在相同時間裡,被交付了更多工作?這也是 AI 郵報發起「2026 AI 郵報讀者調查」的原因。 不只問你有沒有用 AI,而是用了之後發生什麼事 多數 AI 調查關心的是使用率、熱門工具或使用頻率。但「有沒有使用 ChatGPT」,已經不足以描述
日本一位沒有員工的稅務士,靠著 Claude Code 與自動化系統,成功服務 60 家客戶公司,打破傳統需要 6 名員工、年耗千萬日圓的人事常規。本文深度解析「AI First」的思維轉變——不再只是把 AI 當成卡關時的輔助工具,而是將工作設計成一套可自動運作的「公司系統」;並透過 Supervisor、Crew、Graph、Tool Use 四種 Agent 架構,解析如何打造高效率的企業級 AI 工作流。同時探討在多模型、多 Agent 常駐的趨勢下,如技嘉 AI TOP 500 TRX50 這類本地硬體基礎設施,如何成為 AI First 真正落地的關鍵。
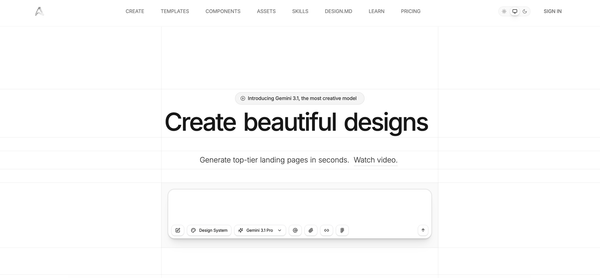
看到喜歡的網站卻不知如何拆解?Aura.build 最新「URL 轉 DESIGN.md」功能,能一鍵抓取版型、字體與顏色。本文實測這個設計師專屬的 AI 工作流,解析優缺點與實戰避坑指南。
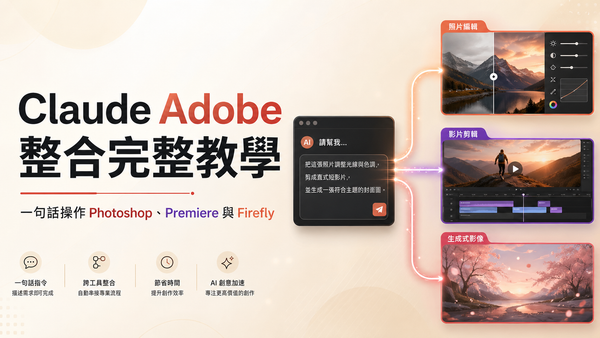
Adobe 與 Anthropic 合作推出「Adobe for creativity connector」,讓你在 Claude 對話框內直接調用 50 多個 Adobe 專業工具,包含 Photoshop、Premiere、Firefly、Lightroom 與 Express。本文完整說明安裝步驟、三大實用場景與兩個實作示範,讓你不用學軟體操作就能做出成品。
Make Tech Fun. Make Knowledge Flow. Make AI for Everyone.
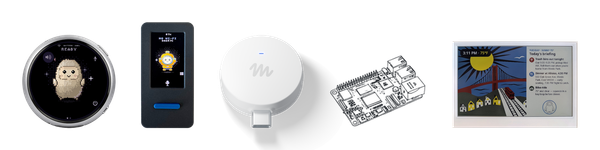
Muse Gadgets SDK 讓 ESP32 與 Linux 裝置接入 Muse,近期 DIY AI 伴侶在 X 引起討論。本文解析韌體、帳號、配對與雲端分工,說明為何開源 SDK 不等於把大型模型放進小晶片。
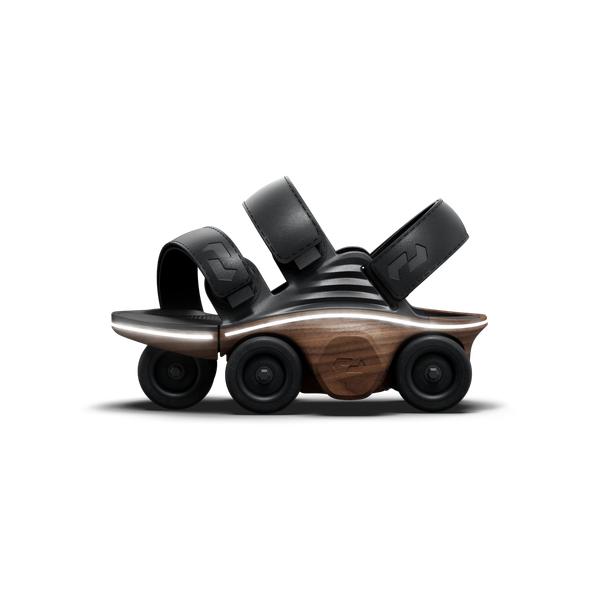
Shift Robotics 推出 Moonwalkers DUSK,讓穿在鞋外的機器人裝置配合步態提供動力。本文整理官方價格、出貨資訊、尺寸速度與 SENSA 控制,說明它和溜冰鞋的差別及使用前應確認的條件。
Daimon 在 IROS 2026 展示串珠與帆布袋製作,強調觸覺感測、資料與世界模型。本文拆解視覺和觸覺的分工、DM-Tac 與 TWM,說明展示能證明什麼,以及量產仍需哪些證據。
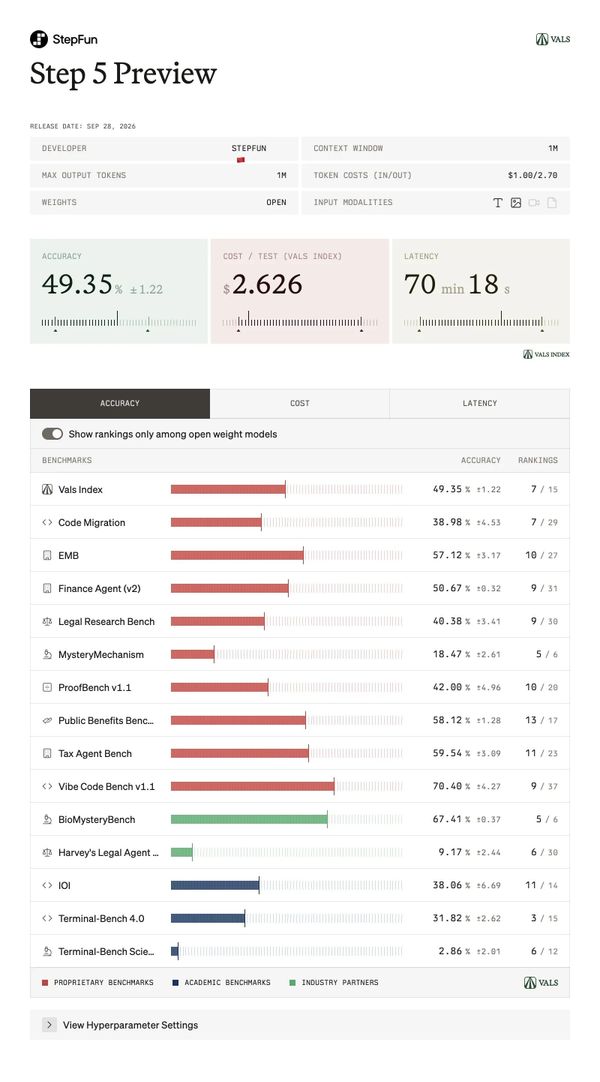
Step 5 Preview 支援百萬 token 上下文與圖片、影片輸入,近期登上 Vals 排行榜。本文解析官方規格、榜單第七的分類與模型接入,說明長上下文、多模態和開放權重不能混為一談。
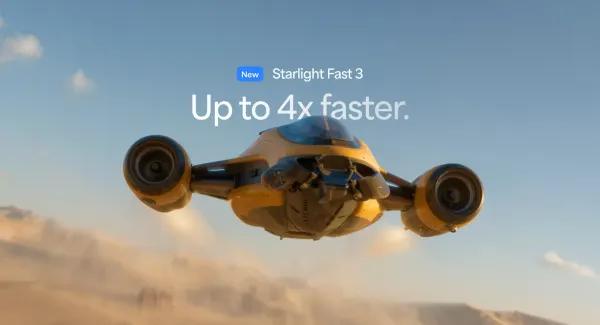
Topaz Starlight Fast 3 主打比 Precise 更快的影片放大,九月更新另加入 Speed Boost。本文比較官方速度案例、點數與 HDR 限制,說明創作者如何以同一段素材評估畫質和時間。
DMAD 用對抗式蒸餾,把 MiniMax-H3 影音生成縮減到四步,並提供低視訊記憶體模式。本文解析四步的意思、官方範例、LoRA 與硬體需求,說明為何步數變少不等於免費快速生成影片。
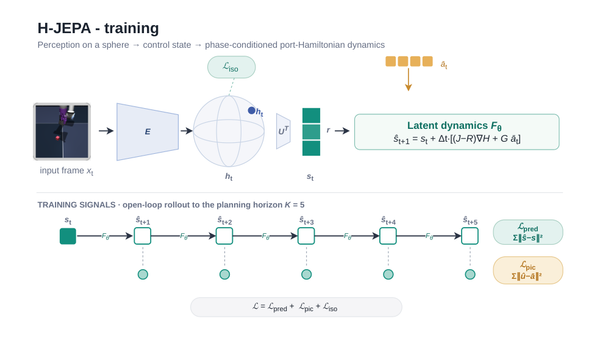
H-JEPA 把視覺感知與控制狀態分開,使用帶有物理結構的預測器協助規劃。本文用機械手臂例子拆解 JEPA、潛在狀態與模擬測試,說明它和 AI 影片生成有何不同。
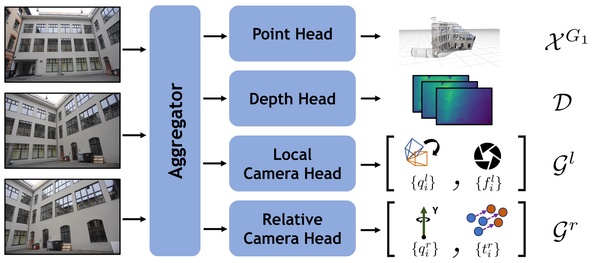
G3T 用重力方向對齊三維重建,並以片段方式處理長影片。本文拆解點雲、相機姿態與 G3TLong,說明研究能做什麼、官方程式如何使用,以及為何重建結果不等於精密測量。
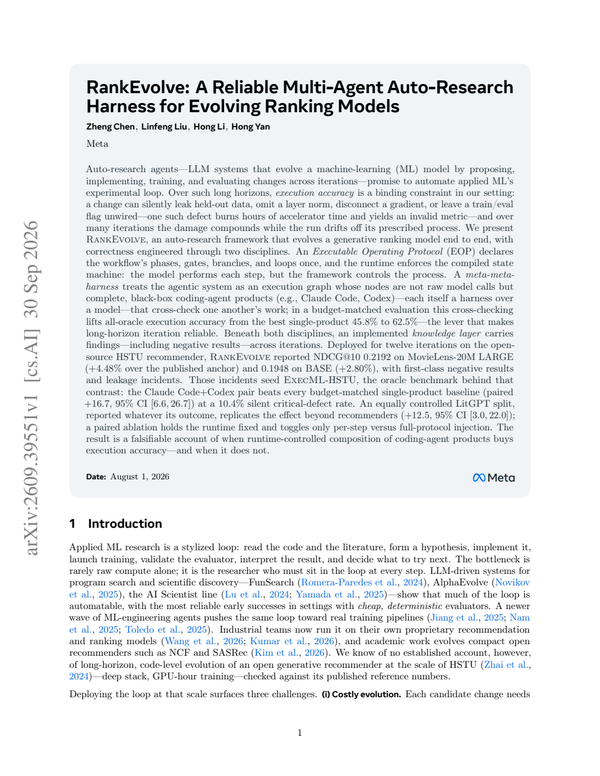
Meta RankEvolve 把完整程式代理組合成研究流程,讓 Claude Code 與 Codex 互相檢查。本文解析可執行流程規則、推薦模型實驗與錯誤率,說明多代理研究如何避免漂亮分數掩蓋實作缺陷。
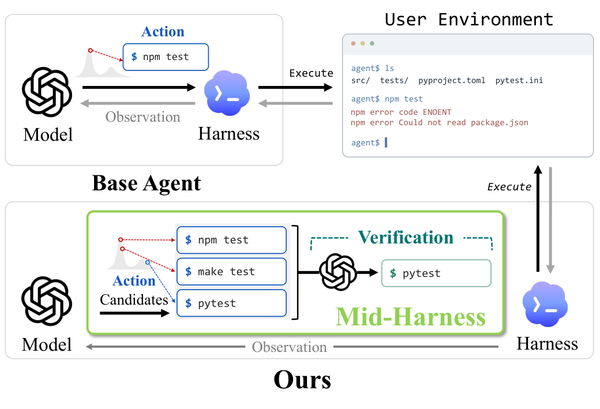
NVIDIA Mid-Harness 先產生多個候選動作,再由驗證模型選擇執行。本文解析終端代理、八個候選的實驗結果與成本,說明為何多想幾個方案不夠,還需要可靠的判斷。
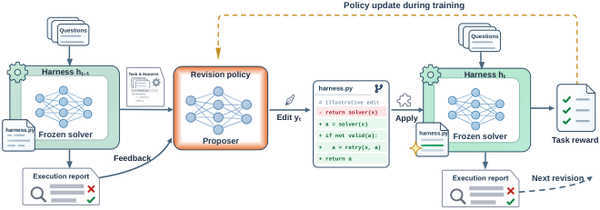
Harness Learning 訓練一個流程提案模型,讓 AI 根據執行回饋修改解題程式。本文解析提案者與解題者分工、測試時調整及研究限制,說明它和一般自我反省提示詞有何不同。
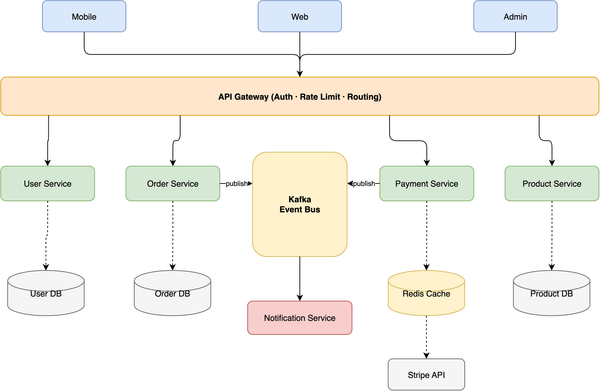
drawio-skill 能把自然語言、程式碼與基礎設施設定轉成可編輯的 draw.io 圖。本文介紹架構圖、來源追蹤、增量更新與圖表檢查,說明它和一般 AI 生圖有何差別,以及如何評估成果。